Version 0.1.0: Vom leeren Ordner zum ersten Arbeitswerkzeug
Ende Juli habe ich mit GODAV Pro angefangen, einem Projektmanagementsystem für Projekte, Aufgaben, Anforderungen, Risiken, Tickets und Teams. Gedacht ist es als Arbeitswerkzeug für Projektleitungen, Fachabteilungen und operative Teams, also nichts zum Herzeigen, sondern etwas, womit man den ganzen Tag arbeitet. Version 0.1.0 umfasst die ersten 97 Builds in gut einer Woche. In diesem Beitrag erzähle ich, womit alles angefangen hat und was am Ende dieser ersten Woche schon funktionierte.
Bevor die erste Zeile Fachlogik stand
Die ersten Commits enthielten noch keine einzige Funktion, die ein Anwender je zu sehen bekommt. Sie bestanden aus Gerüst und Regeln. Das war Absicht, denn was man am ersten Tag versäumt, bekommt man später kaum noch nachgezogen.
Ein Repository für alles. Frontend und Backend liegen zusammen in einem Monorepo, dazu zwei gemeinsame Pakete: eines mit den Verträgen, also der genauen Form jeder Anfrage und Antwort zwischen Browser und Server, und eines mit den Funktionen, die diese Anfragen stellen. Ich hätte Frontend und Backend auch in getrennte Repositories legen und die Verträge als eigenes Paket veröffentlichen können. Dann wären bei jeder Vertragsänderung aber drei Änderungen an drei Stellen nötig gewesen, und dazwischen hätte es immer einen Moment gegeben, in dem beide Seiten nicht zusammenpassen. So ist eine Vertragsänderung eine einzige Änderung, und wenn eine Seite nicht mehr dazu passt, meldet das sofort der Compiler.
TypeScript, und zwar streng. Alles ist in TypeScript geschrieben, mit den strengsten Einstellungen, die es gibt. Dazu zählen zwei, die selbst erfahrene Entwickler erst einmal ärgern: Wer auf das erste Element einer Liste zugreift, muss damit rechnen, dass es keines gibt, und ein optionales Feld bedeutet „fehlt“ und nicht „ist leer“. any, also „hier ist mir der Typ egal“, ist verboten. Diese Regeln kosten am Anfang etwas Tempo. Dafür findet der Compiler genau die Fehler, die einem sonst erst im Betrieb um die Ohren fliegen.
Ich bin dabei bewusst bei TypeScript 5.9 geblieben, obwohl schon die deutlich schnellere Version 7 erschienen war: Linter und Testumgebung unterstützten sie noch nicht offiziell. Eine Werkzeugkette, die nicht zusammenpasst, war mir das Tempo nicht wert, zumal das Projekt ohnehin in Sekunden baut.
Clean Architecture im Backend. Jedes Modul im Server hat drei Schichten. Die äußere nimmt HTTP-Anfragen entgegen, die mittlere enthält die eigentliche Fachlogik, und die innerste spricht mit der Datenbank. Die Fachlogik weiß nichts über HTTP und nichts über die Datenbank. Sie kennt nur Schnittstellen, die ihr jemand von außen erfüllt. Das klingt nach Lehrbuch, ich habe es aber aus einem handfesten Grund so gebaut: wegen der Testbarkeit. Ein Service, der nur gegen eine Schnittstelle programmiert ist, lässt sich in Millisekunden testen, ohne laufende Datenbank. Auch den Fall „Datenbank ausgefallen“ kann man so prüfen, indem man das Testdouble einfach so antworten lässt.
Am wichtigsten war mir dabei, dass diese Regel maschinell durchgesetzt wird. Architekturregeln, die nur in einem Dokument stehen, werden unter Zeitdruck gebrochen, meist zusammen mit einem Kommentar, warum gerade dieser eine Fall eine Ausnahme ist. Deshalb verbietet der Linter einem Controller, die Datenbank zu importieren, und einem Service ebenso. Wer die Grenze überschreiten will, muss zuerst die Regel ändern und das begründen.
Ein Modell für alle Vorgänge. Epic, Feature, User Story und Task liegen in einer Tabelle mit einem Typfeld, nicht in vier getrennten. Den Ausschlag haben Kommentare und Anhänge gegeben. Bei vier Tabellen müsste ein Kommentar auf „irgendeine von vier“ zeigen, und das kann die Datenbank nicht absichern. Verwaiste Kommentare wären dann nur eine Frage der Zeit. Mit einer Tabelle ist es ein ganz normaler Fremdschlüssel. Wie richtig das war, hat sich schon in dieser Version gezeigt, als Sonderaufgaben und Requests als fünfte und sechste Vorgangsart dazukamen: jeweils ein zusätzlicher Wert statt einer neuen Tabelle samt eigenem Service.
Nichts verschwindet sofort. Fachobjekte wie Projekte, Vorgänge, Kommentare und Konten werden nicht wirklich gelöscht, sondern nur als gelöscht markiert. Der Haken an diesem „weichen Löschen“ ist bekannt: Jede Abfrage muss die markierten Zeilen ausfiltern, und wer das vergisst, zeigt gelöschte Daten an, ohne dass irgendetwas fehlschlägt. Deshalb gibt es dafür genau einen Helfer, den jede Leseabfrage benutzt. Und weil die Datenbank ihre Kaskaden nur beim echten Löschen ausführt, baue ich sie von Hand nach: Wer ein Projekt löscht, markiert alle seine Vorgänge mit, und zwar in einer einzigen Transaktion.
Zwei Sprachen von Anfang an. Englisch ist die Referenzsprache, Deutsch die zweite. Im Quelltext steht kein einziger sichtbarer Text, alles kommt aus Katalogen, deren Schlüssel der Compiler prüft. Ein Tippfehler im Schlüssel ist also ein Compilerfehler und kein leeres Feld im Browser. Auch der Server übersetzt seine Fehlermeldungen. Die Sprache dafür nimmt er aus der Anfrage des Browsers und nicht aus dem Profil des Nutzers. Sonst würde er nach einem Sprachwechsel noch eine Weile in der alten Sprache antworten, und das sähe aus wie ein Fehler.
Wer darf was sehen und tun
Das Berechtigungsmodell war die erste große fachliche Entscheidung, und es ist bis heute das Fundament.
Jeder Nutzer hat eine globale Rolle. In einem Projekt kann eine andere Rolle gelten, und die ersetzt die globale, statt sie zu ergänzen. Der Unterschied klingt klein, ist aber entscheidend. Würden die Rechte nur addiert, könnte man jemandem in einem einzelnen Projekt nie weniger erlauben als sonst. Damit beim Beitritt zu einem Projekt niemand still Rechte verliert, wird die globale Rolle als Vorschlag übernommen.
Was jemand sehen darf, ergibt sich nicht aus einer Berechtigung, sondern aus der Mitgliedschaft. Wer in einem Projekt Mitglied ist, sieht es, alle anderen nicht. Hätte ich zusätzlich eine Berechtigung „Projekt lesen“ eingeführt, gäbe es zwei Mechanismen für dieselbe Frage, und an jeder Prüfstelle müsste man neu klären, welcher gewinnt. Die einzige Ausnahme ist die Betrachterrolle: Sie darf jedes Projekt lesen, aber nirgends etwas ändern. Für ein fremdes Projekt antwortet der Server außerdem mit „nicht gefunden“ und nicht mit „verboten“, denn ein „verboten“ würde verraten, dass es das Projekt gibt.
Seit dieser Version werden Rechte außerdem je Vorgangsart vergeben: Epics anlegen ist etwas anderes als Tasks anlegen. Beim Löschen prüft die Anwendung zusätzlich jede Art, die darunter hängt. Sonst wäre „Features löschen“ heimlich auch „dreißig Tasks löschen“.
Zwei Dinge gibt es bewusst nicht als vergebbares Recht, nämlich „Rollen verwalten“ und „Nutzer verwalten“. Eine Rolle, die Rollen verwalten darf, könnte sich selbst jedes weitere Recht geben. Und wer Nutzer anlegen darf, kann sich ein zweites Konto mit Administratorrechten basteln. Beides bleibt deshalb fest dem Administrator vorbehalten.
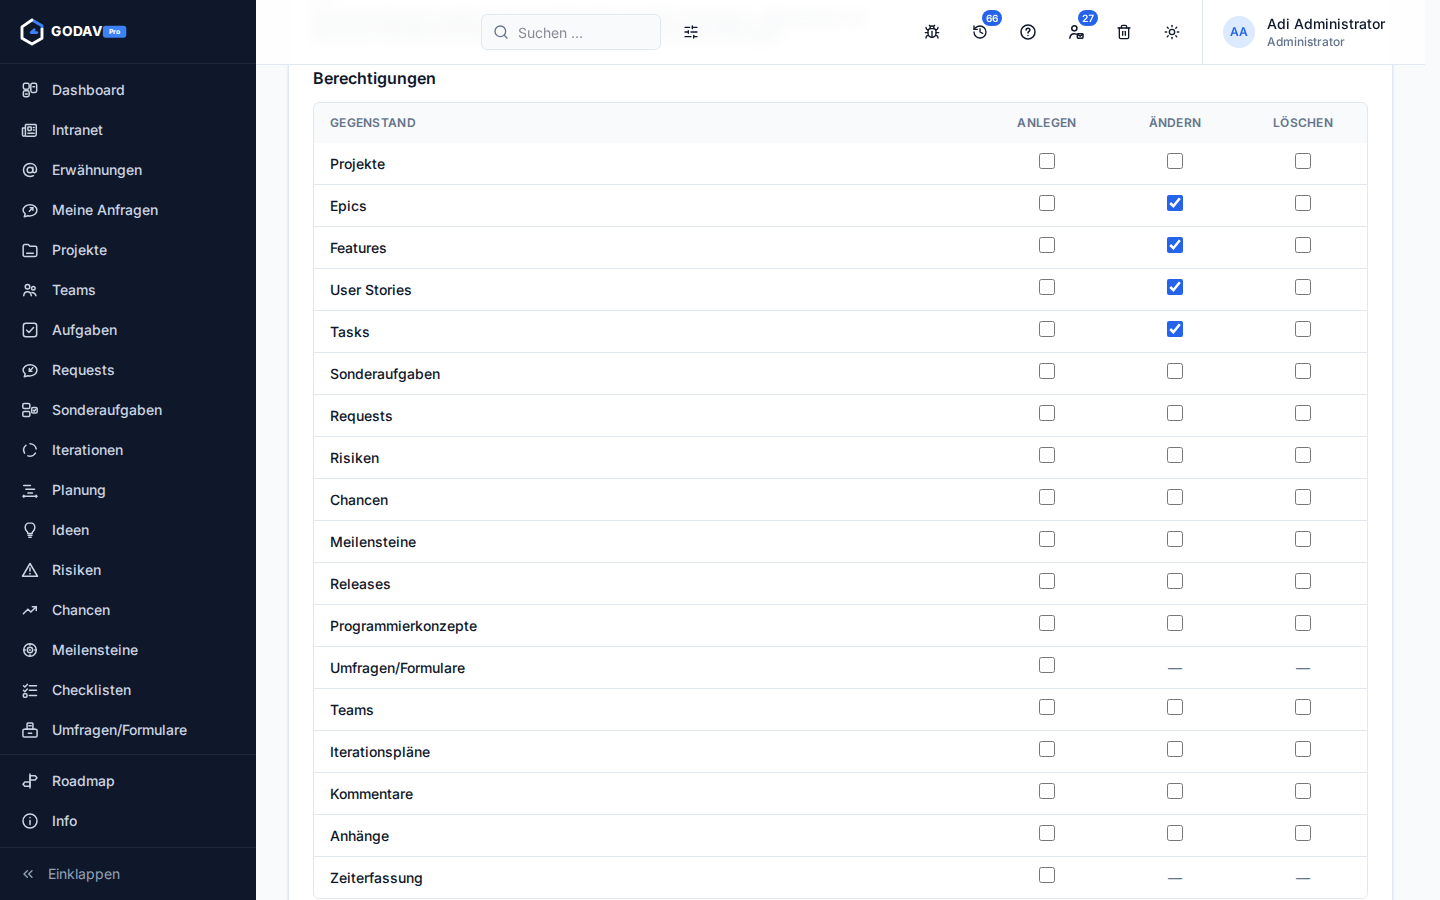 Die Berechtigungsmatrix einer Rolle (heutiger Stand, mit allen Gegenständen, die seitdem dazugekommen sind).
Zwei Statusfelder statt einem
In dieser Woche ist eine Entscheidung gefallen, die ich für eine der wichtigsten im ganzen Projekt halte. Jeder Vorgang hat zwei Status.
Der erste ist der Systemstatus: ein fester, nicht änderbarer Wertevorrat (Neu, Offen, Geplant, In Bearbeitung, Im Test, Freigegeben, Erledigt, Verworfen). Gegen ihn rechnet die Anwendung: Ist etwas erledigt, ist es offen, ist es überfällig? Eine Auswertung über alle Projekte hinweg funktioniert nur, wenn überall dieselben Werte stehen.
Genau deshalb reicht er allein nicht aus. Was ein Team im Alltag wirklich sagt, etwa „Im Review bei QS“ oder „Warte auf Rückmeldung“, passt in keine feste Liste. Deshalb trägt jeder Prozess eigene Statuswerte je Vorgangsart, frei benennbar und sortierbar, und jeder davon ist einem Systemstatus zugeordnet. Das Team sieht und pflegt seine eigenen Werte, die Auswertungen rechnen mit dem Systemstatus darunter.
Ich hätte den Systemstatus auch einfach erweiterbar machen können. Das endet aber erfahrungsgemäß bei einer Liste, die für jedes Team zu lang und für keines passend ist. Damit beide Felder nie auseinanderlaufen, wird der Systemstatus nie getrennt gespeichert, sondern beim Schreiben direkt aus dem gewählten Statuswert abgeleitet. Was nicht abweichen kann, ist keine zweite Wahrheit.
Das Aufgabenboard
Der Menüpunkt „Aufgaben“ führt auf ein Kanbanboard: Spalten sind die Statuswerte, Zeilen die Personen. Karten lassen sich mit der Maus verschieben, aber auch mit der Tastatur (Griff anfassen, Leertaste, Pfeiltasten, Leertaste). Die Spalte setzt den Status, die Zeile die zuständige Person, und angeboten wird nur, was auch erlaubt ist.
Zwei Zeilen finde ich besonders nützlich: „Ohne Zuordnung“ für alles, was niemand übernommen hat, und „Verwaiste Zuordnung“ für Vorgänge, deren Zuständige das Projekt verlassen haben. Gerade die zweite fällt sonst niemandem auf. Dazu gibt es Filter, gespeicherte Ansichten, die am Konto hängen und deshalb auf jedem Gerät verfügbar sind, und einen zweiten Reiter mit derselben Auswahl als sortierbare Tabelle.
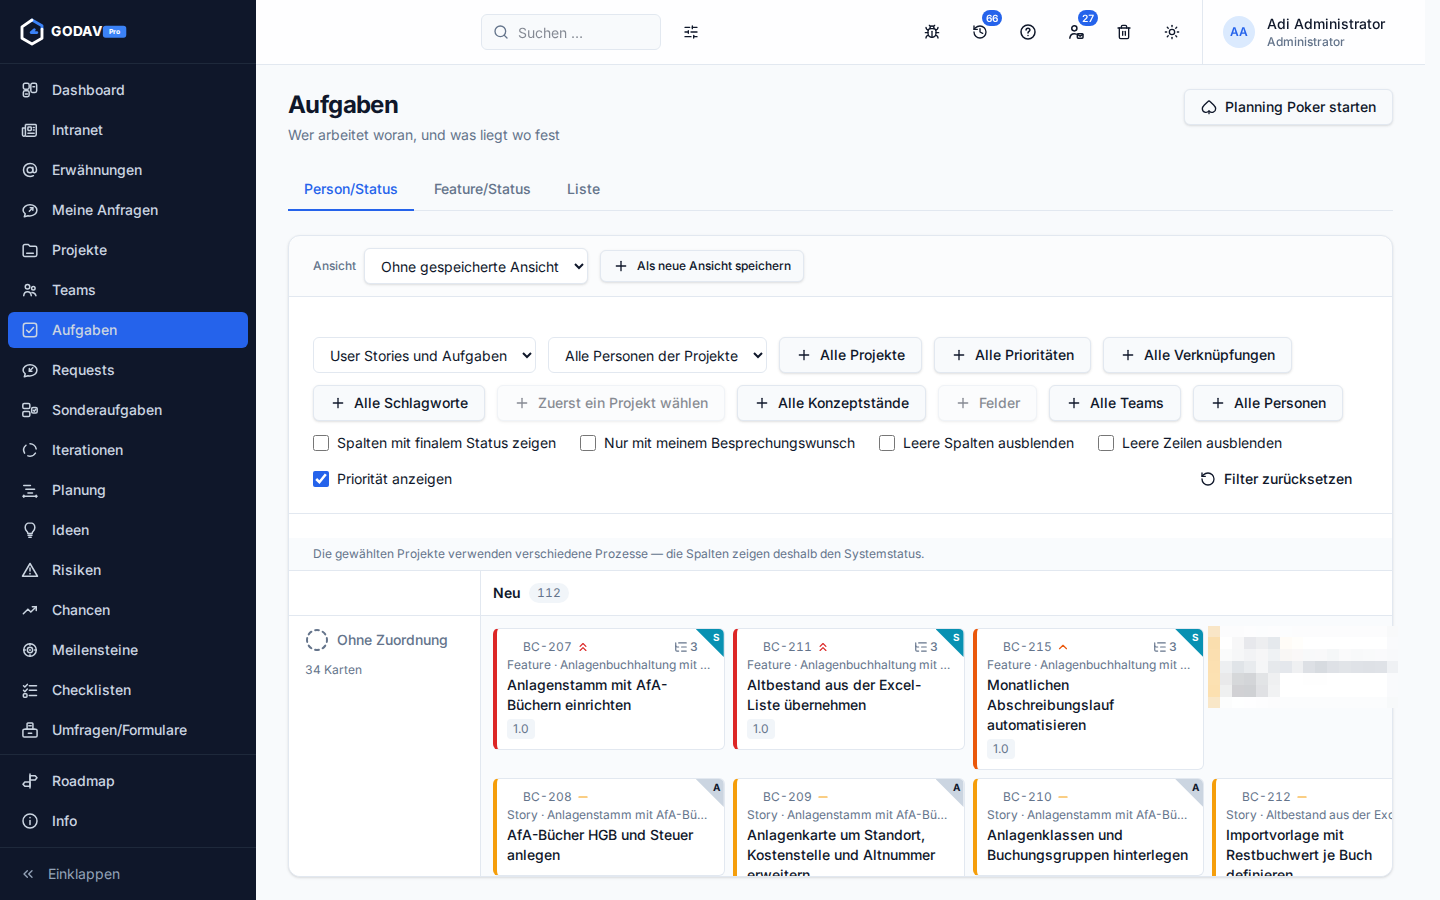 Das Aufgabenboard, wie es heute aussieht. Die Grundidee mit Spalten je Status und Zeilen je Person stammt aus dieser ersten Version.
Dazu passt die Priorität, die ich bewusst nicht als Badge darstelle, sondern als farbigen Text mit Symbol, in fünf Stufen von „Kritisch“ bis „Unwichtig“. Zwei Pillen nebeneinander in einer Tabellenzeile wären kaum auseinanderzuhalten. Fünf Stufen bekommen fünf verschiedene Symbole, damit sie auch unterscheiden kann, wer Rot und Orange nicht auseinanderhält.
Lehrreich war ein Fehler: Filter auf „nein“ wirkten wie „ja“, weil das Framework Werte aus der Adresszeile umwandelt, bevor meine eigene Umwandlung sie sieht, und aus „false“ dabei true wird. Nichts stürzte ab, die Filter zeigten nur still die falsche Hälfte. Jetzt wird der Rohwert gelesen, und ein Test hält das fest.
Zeiterfassung
An User Stories und Tasks lassen sich Zeiten buchen, von Hand oder per Stoppuhr. Es läuft immer nur eine Erfassung gleichzeitig. Wer an einem anderen Vorgang startet, beendet damit die laufende, und die eigene Uhr steht auf jeder Seite in der Kopfzeile. Erfasst gerade jemand anderes Zeit am selben Vorgang, sieht man das auf der Karte. So fällt auf, wenn zwei an derselben Sache sitzen.
Die Seite „Zeiterfassung“ hat am Ende der Version alle vier Bereiche: buchbare Sonderaufgaben, der eigene Arbeitstag mit Soll, Ist und Differenz, die zuletzt bearbeiteten Vorgänge und die Tage, die noch nachzutragen sind. Das Soll kommt aus einem Arbeitszeitplan je Wochentag. Die Wochenstunden sind dort keine eigene Zahl, sondern die Summe der Arbeitstage, damit beides nie auseinanderläuft.
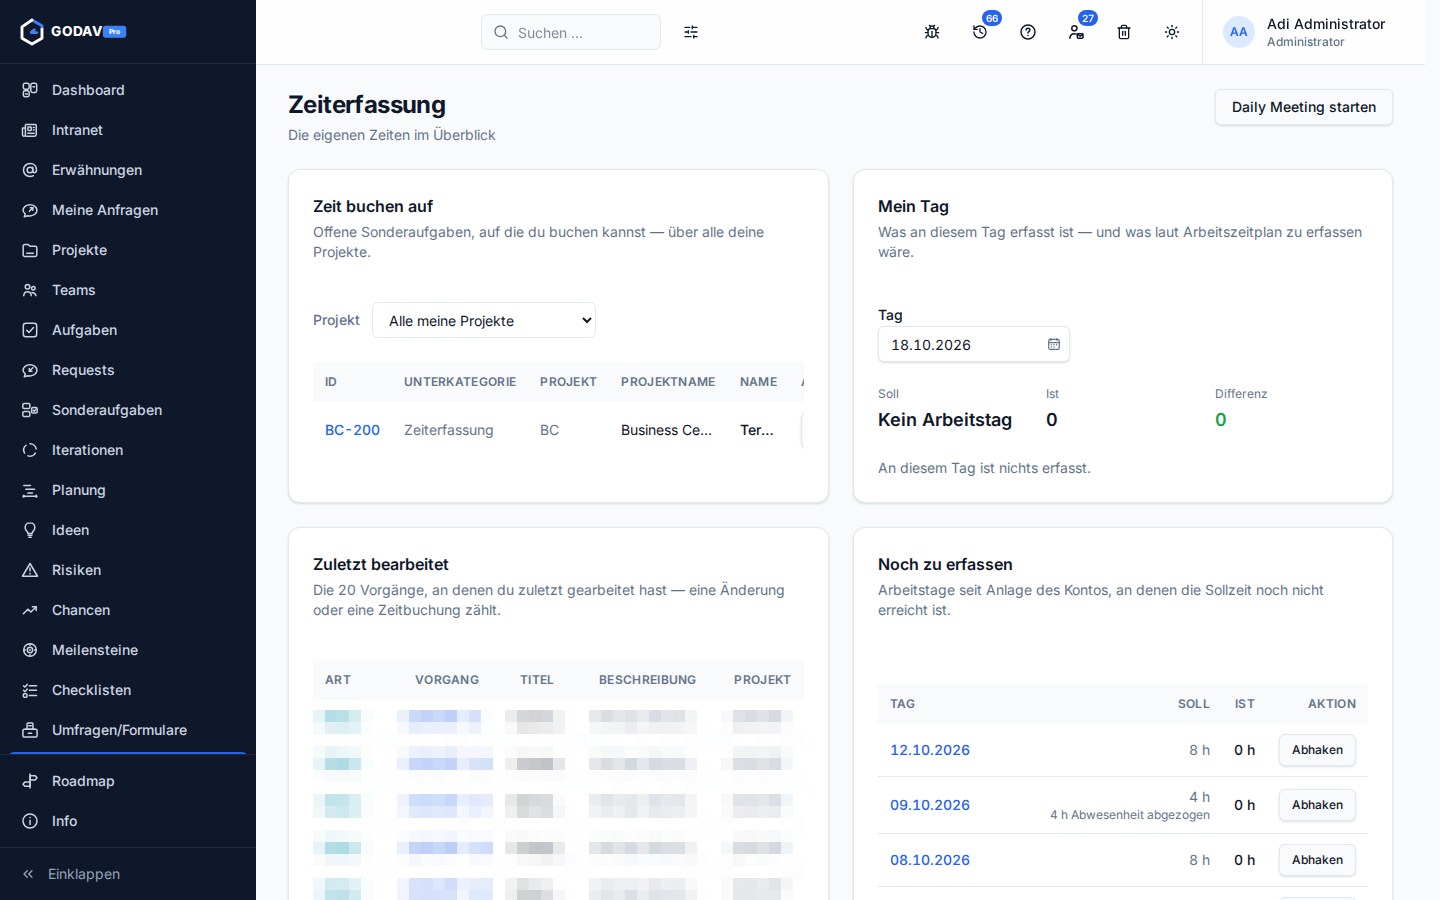 Die Zeiterfassung mit ihren vier Bereichen (heutiger Stand).
Für Arbeit, die zu keinem Planungsvorgang gehört, gibt es die Sonderaufgaben. Sie hängen direkt am Projekt statt in der Hierarchie Epic → Feature → Story → Task, und ihre Statuswerte sind nicht einrichtbar. Sie haben ein eigenes Rechtetripel bekommen und nutzen nicht das der Tasks mit, sonst hieße „Aufgaben anlegen“ heimlich auch „Sonderaufgaben anlegen“.
Kommentare, Erwähnungen und die ersten Mails
In Kommentaren lassen sich Personen und Teams mit @ erwähnen. Die Seite „Erwähnungen“ sammelt alles, was eine Reaktion von dir erwartet. Wer antwortet oder den Vorgang abschließt, räumt den Eintrag automatisch weg.
Außerdem verschickt die Anwendung in dieser Version zum ersten Mal Mails. Der Postausgang wird in der Oberfläche eingerichtet, Vorlagen werden je Sprache gepflegt, und Platzhalter werden schon beim Tippen geprüft. Mir war vor allem eines wichtig: Jeder kann Mails für sich vollständig abbestellen, und niemand sonst kann diesen Haken setzen oder entfernen. Administratoren können einzelne Mailfunktionen je Prozess abschalten, das eigene Abbestellen gewinnt aber immer.
Requests und Ideen
Zum Schluss sind noch Requests als sechste Vorgangsart dazugekommen, mit einem eigenen Board nach demselben Muster wie bei den Aufgaben. Dazu gibt es eine Unterkategorie „Idee“ mit eigener Ansicht als Blog. Jede Person hat in jedem Projekt 20 Punkte, die sie frei auf Ideen verteilt. So zeigt sich, was zuerst angegangen werden soll. Über eine Idee zu entscheiden ist ein eigenes Recht, getrennt von „Requests ändern“: Wer Ideen einreichen und bearbeiten darf, soll sie nicht gleich selbst freigeben können.
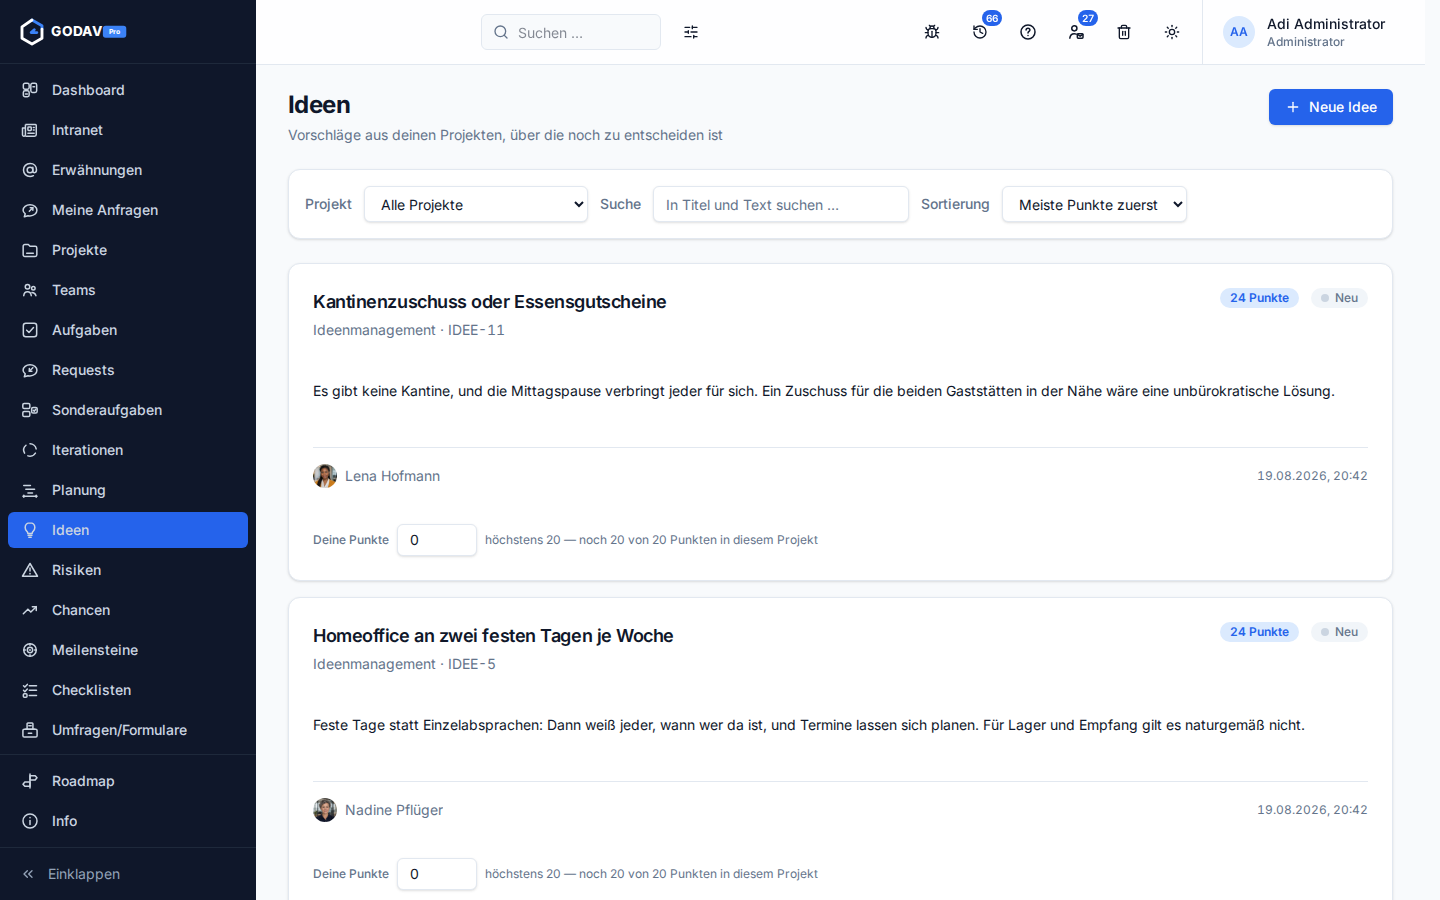 Ideen als Blog, sortiert nach Punkten (Demodaten).
Außerdem
- Eigenes Konto mit Sprache, Bild und Passwort
- Projekte mit eigener Karte, Reitern, Fortschritts- und Infoboxen und einem Vorgangsbaum, dazu eine Maske zum Anlegen mit vorgeschlagenem Kürzel
- Mehrere zuständige Personen je Vorgang und Projekt, Mehrfachauswahl mit Suchfeld
- Teams als Abkürzung für Projektmitgliedschaften: Wird ein Team entfernt, gehen genau die Mitgliedschaften mit, die über das Team entstanden sind
- Deaktivierte Konten bleiben ausgegraut und mit Grund in Auswahllisten stehen, statt einfach zu verschwinden
- Brotkrümelpfad vom Vorgang bis zum Projekt, Titel direkt auf der Karte änderbar
- Änderungsprotokoll („Log“) an Vorgang und Projekt, mit „System“ als Urheber, wenn eine Regel statt eines Menschen etwas geändert hat
- Buildnummer und ein Änderungsverlauf in der Kopfzeile
- Eine öffentlich lesbare Roadmap im Hauptmenü
Wie es weitergeht
Damit war die Grundlage gelegt: Rechte, Prozesse, Statusmodell, ein Board und die Zeiterfassung. In Version 0.2.0 geht es darum, Vorgänge untereinander zu verknüpfen, also Blocker und Dubletten, und diese Verknüpfungen auf den Boards sichtbar zu machen.